Кейс
AI Mne Idet: как мы научили нейросеть определять типаж внешности
Введение
Привет! На связи Антон из MediaBuro — ассоциации выпускников лучшей программы в России по компьютерным наукам — «Прикладной математики и информатики» в Высшей школе экономики.
В современном IT наступил парадокс: стоимость разработки дешевеет, сроки уменьшаются, при этом инноваций в индустрии почти не происходит.
Мы объясняем его так: рост количества свободных специалистов вызван GPT-обезьянами с гранатой. В таком мире вероятность найти хорошего специалиста уменьшается.
Мы, как представители молодой IT-элиты, хотим делиться нашей практикой решений задач в рынке и помогать выпускникам становиться сильнее. Наша миссия — повысить планку стандартов качества проектов в IT-рынке, используя новые технологии для ускорения решений.
Может ли ИИ помочь стилисту в работе?
Наш заказчик — автор популярного бьюти-блога «Мне Идёт» Мария Трофимова (Instagram, Telegram). Блог рассказывает девушкам о стиле и моде. Также команда Марии продаёт услуги имиджмейкинга своей аудитории.
У заказчика был запрос на новые продукты с использованием ИИ, которые были бы релевантны подписчикам, и автоматизацию бизнес-процессов. Дело в том, что весь бизнес завязан на авторскую методику определения «типажа» девушки, и каждый запрос на имиджмейкинг проходил через менеджера, который сначала определял типаж, и потом в зависимости от него давал рекомендации.
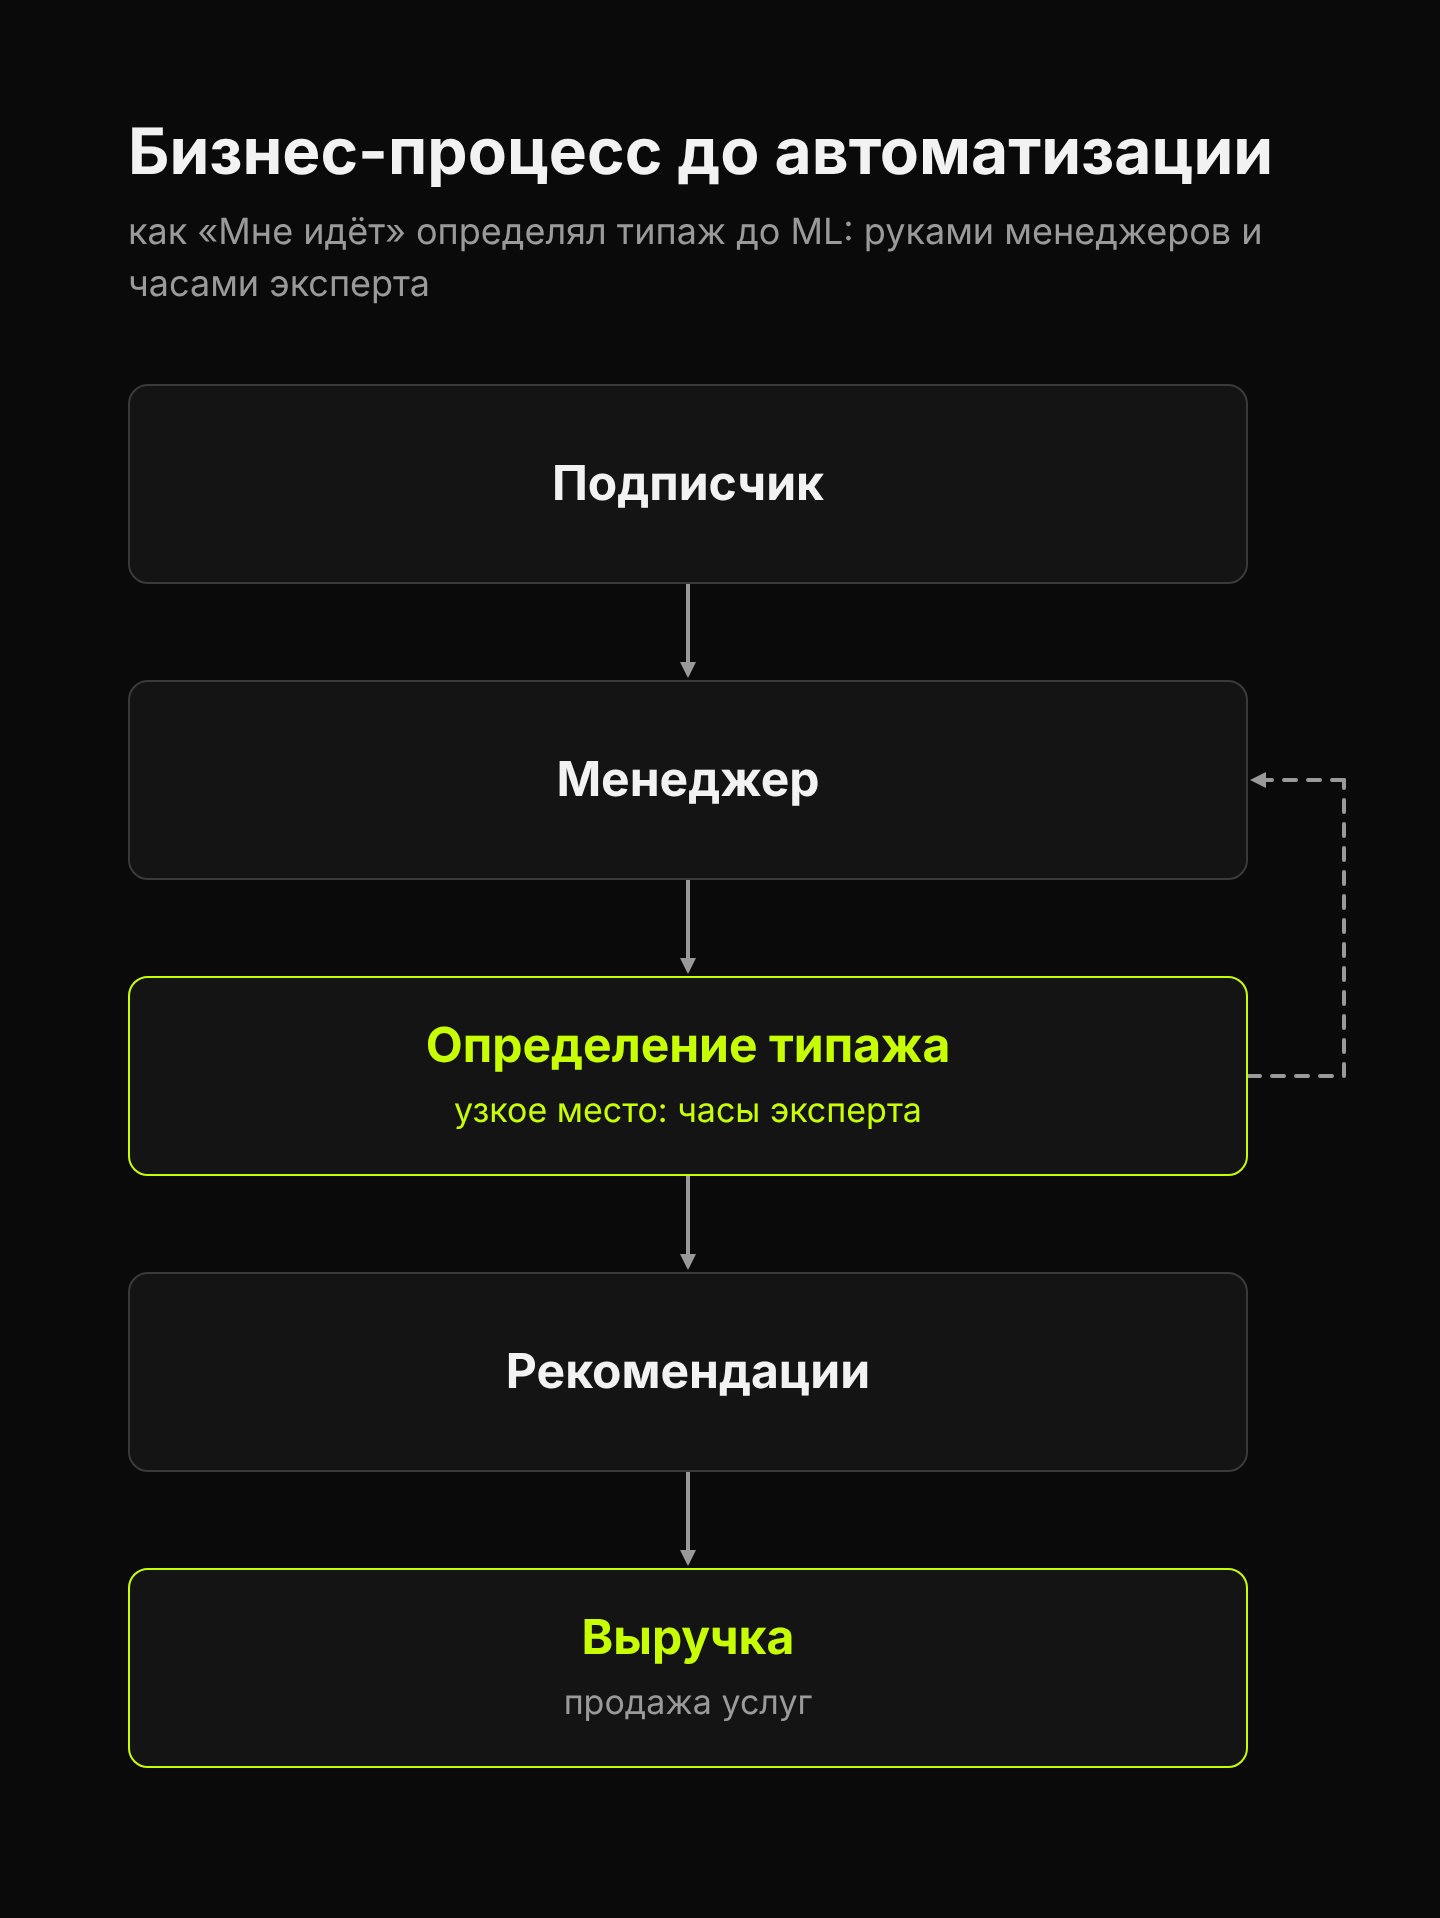
Первая явная гипотеза на оптимизацию: решать задачу типирования с помощью ML, ведь типажей всего 15.
ChatGPT-тест1 показал, что фундаментальные модели тяжело различают лица и не справляются с типированием. Тем не менее команда придумала решение. В открытом доступе есть множество моделей, умеющих распознавать лица и доставать из них признаки — задачи на детекцию лиц, определение возраста человека по лицу решаются всеми бигтехами. Мы рассмотрим несколько самых популярных.
Детекция и классификация лиц. Стандарты индустрии
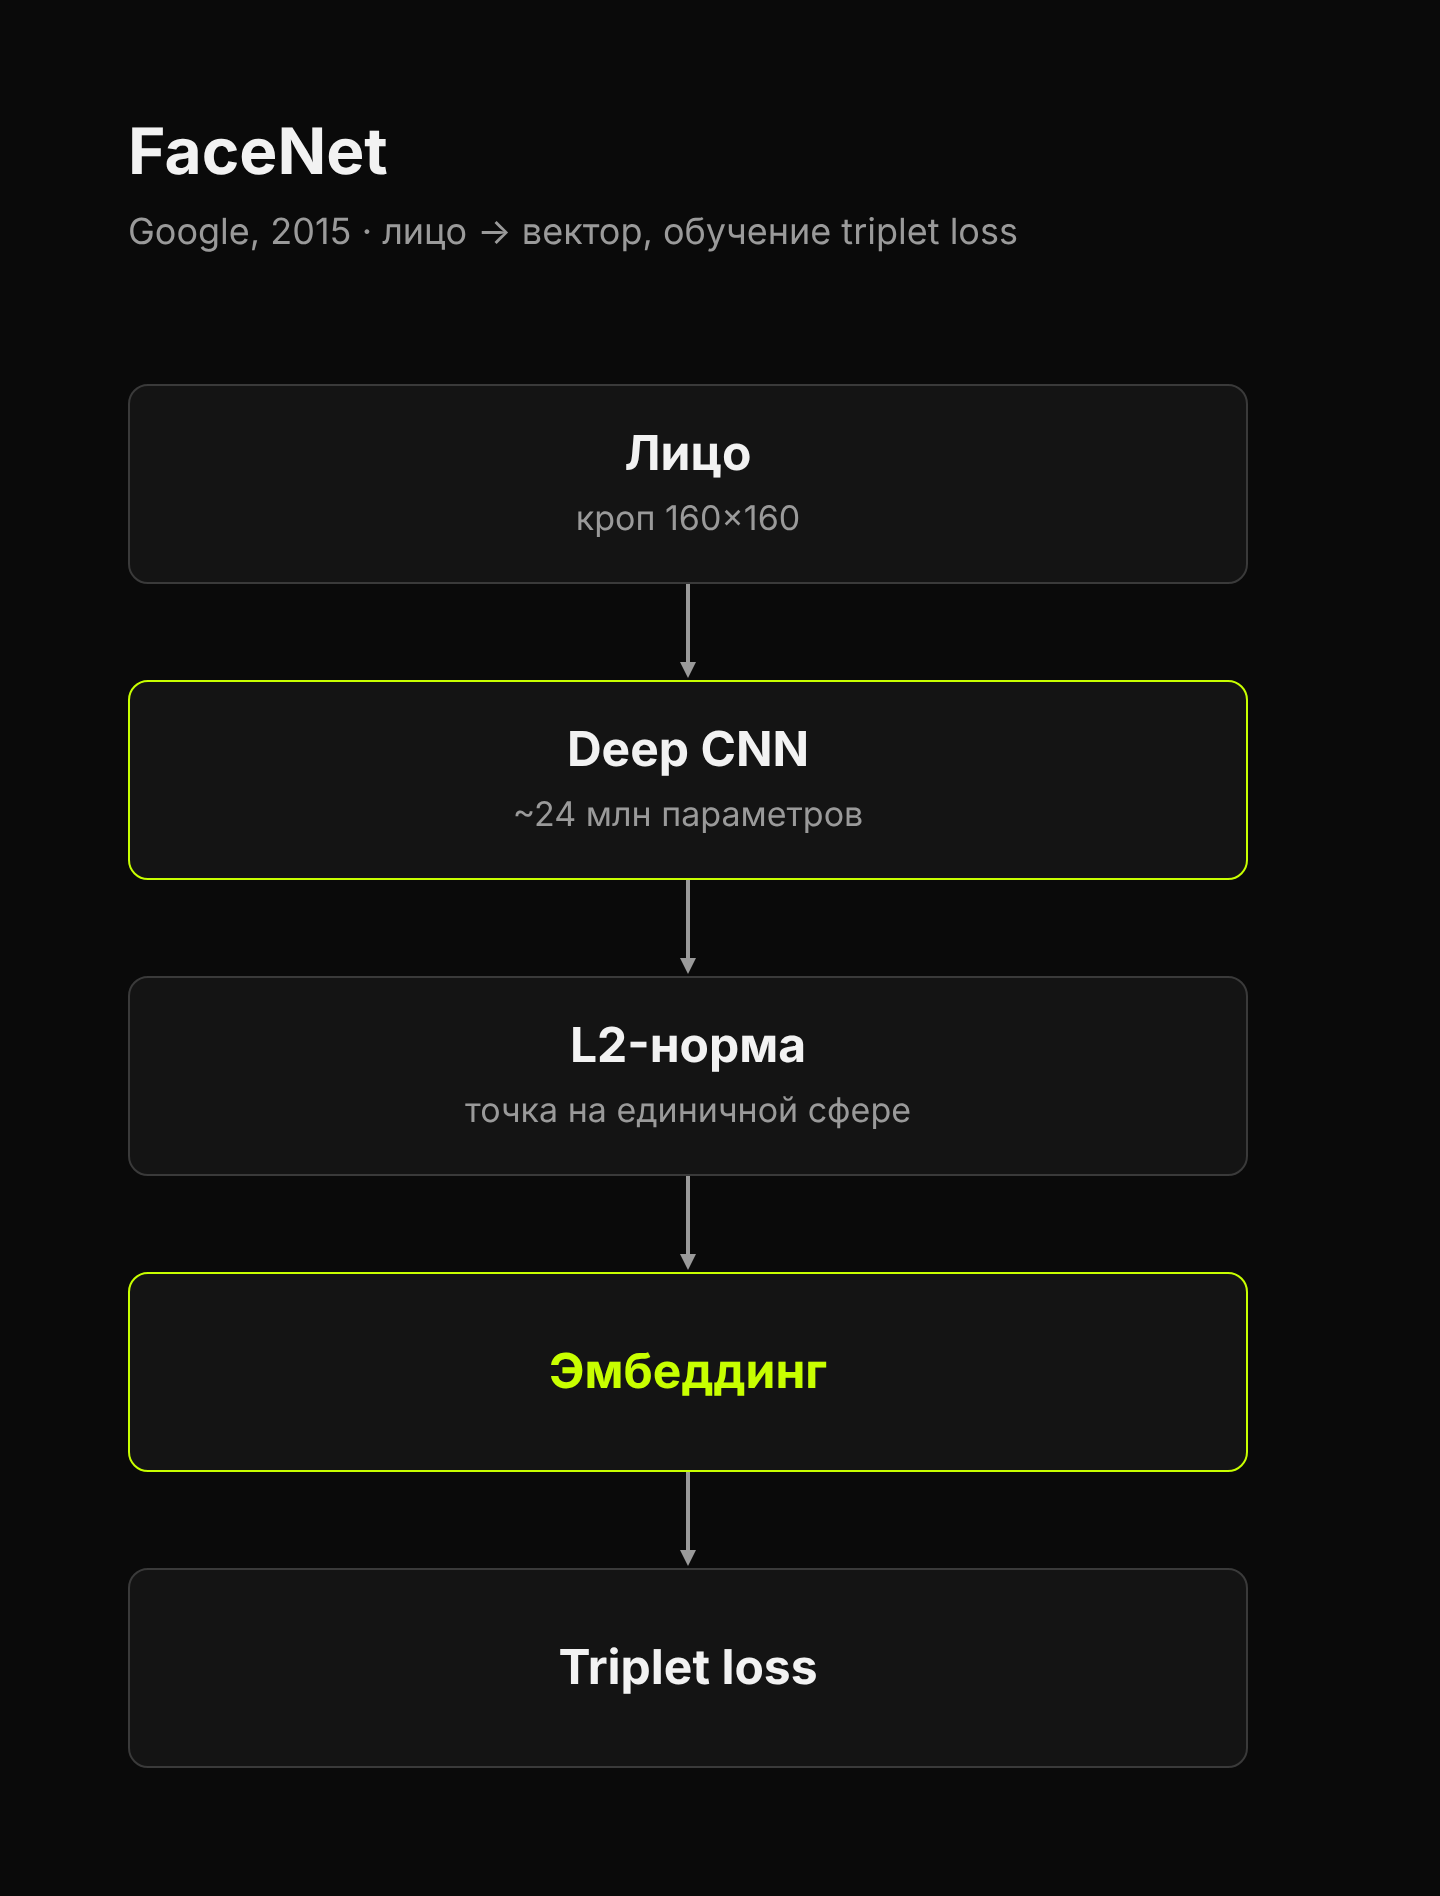
FaceNet (Google, 2015) — Schroff, Kalenichenko, Philbin, «FaceNet: A Unified Embedding for Face Recognition and Clustering», CVPR 2015. Задача, для которой училась: отобразить лицо в компактный вектор (128 чисел в оригинале, 512 в современных реализациях) так, чтобы расстояние между векторами одного человека было маленьким, а между разными людьми — большим. Обучается triplet loss на тройках «anchor — тот же человек — другой человек». Google учил её на сотнях миллионов лиц; открытые реализации (facenet-pytorch) обучены на VGGFace2 и CASIA-WebFace и лежат под MIT.
ArcFace (InsightFace, 2019) — Deng, Guo, Xue, Zafeiriou, «ArcFace: Additive Angular Margin Loss for Deep Face Recognition», CVPR 2019. Цель та же — эмбеддинг лица, но учится как классификатор по личностям: эмбеддинги и веса классов нормируются на гиперсферу, и к углу между ними добавляется отступ m. Softmax с таким отступом заставляет эмбеддинги одного человека собираться плотнее, а разных людей — разводиться по углу. Училась на MS1M и Glint360K (сотни тысяч людей, десятки миллионов фото).
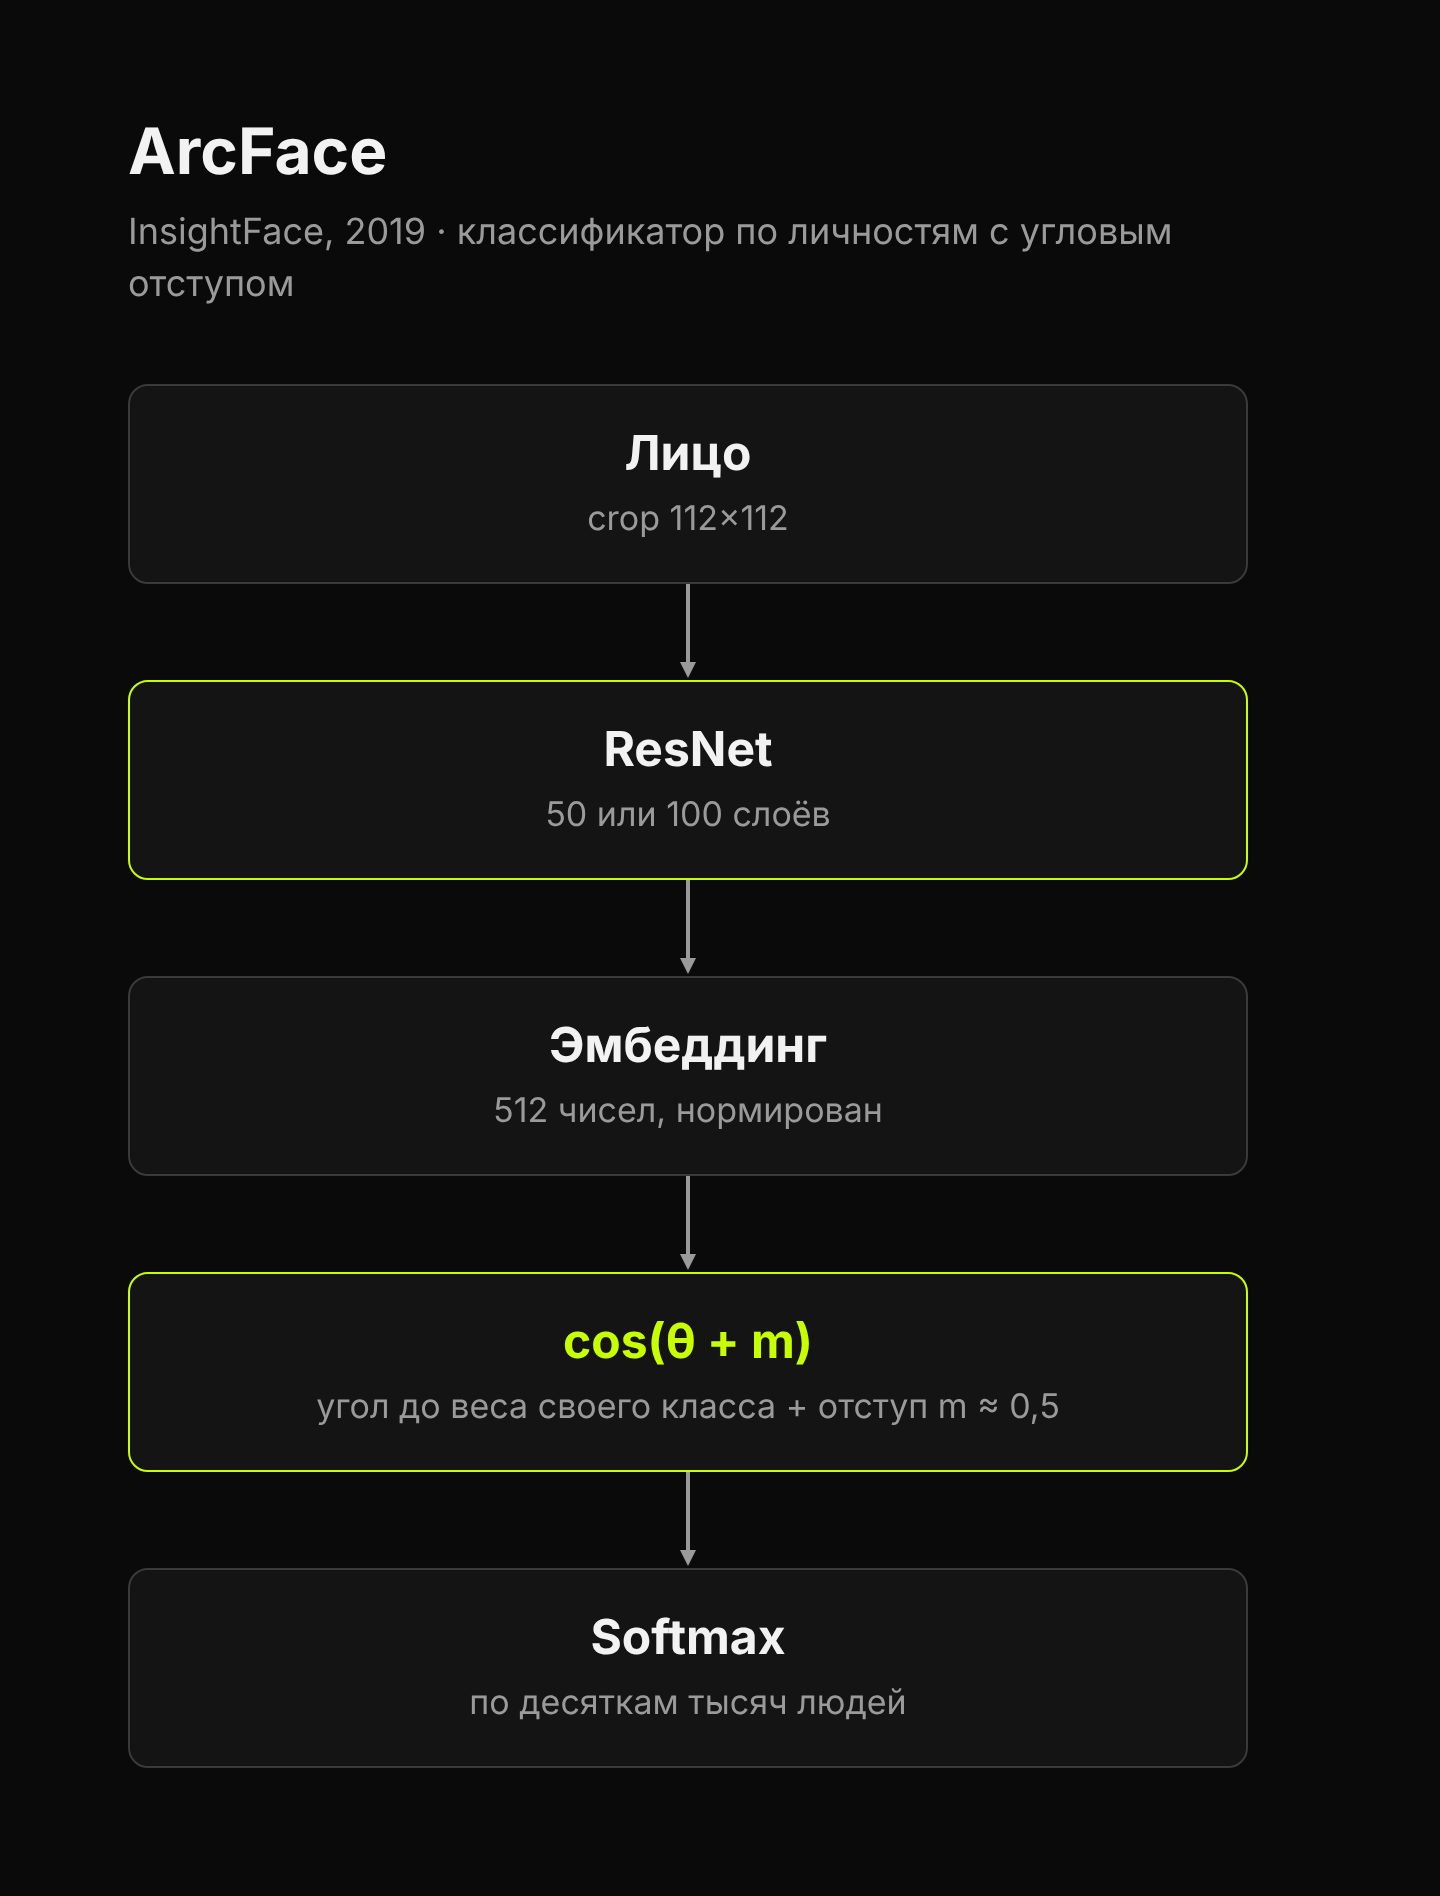
Чем отличаются. FaceNet оптимизирует расстояния напрямую и чувствителен к тому, как подбираются тройки; ArcFace учится обычным softmax с отступом, стабильнее и точнее на бенчмарках распознавания (LFW, MegaFace, IJB-C). Для нашей задачи важнее другое. Нам нужны не различия между людьми, а геометрия лица — она есть в обоих эмбеддингах. А вот лицензии разные: предобученные веса InsightFace распространяются только для некоммерческих исследований, facenet-pytorch — MIT, его можно везти в продукт.
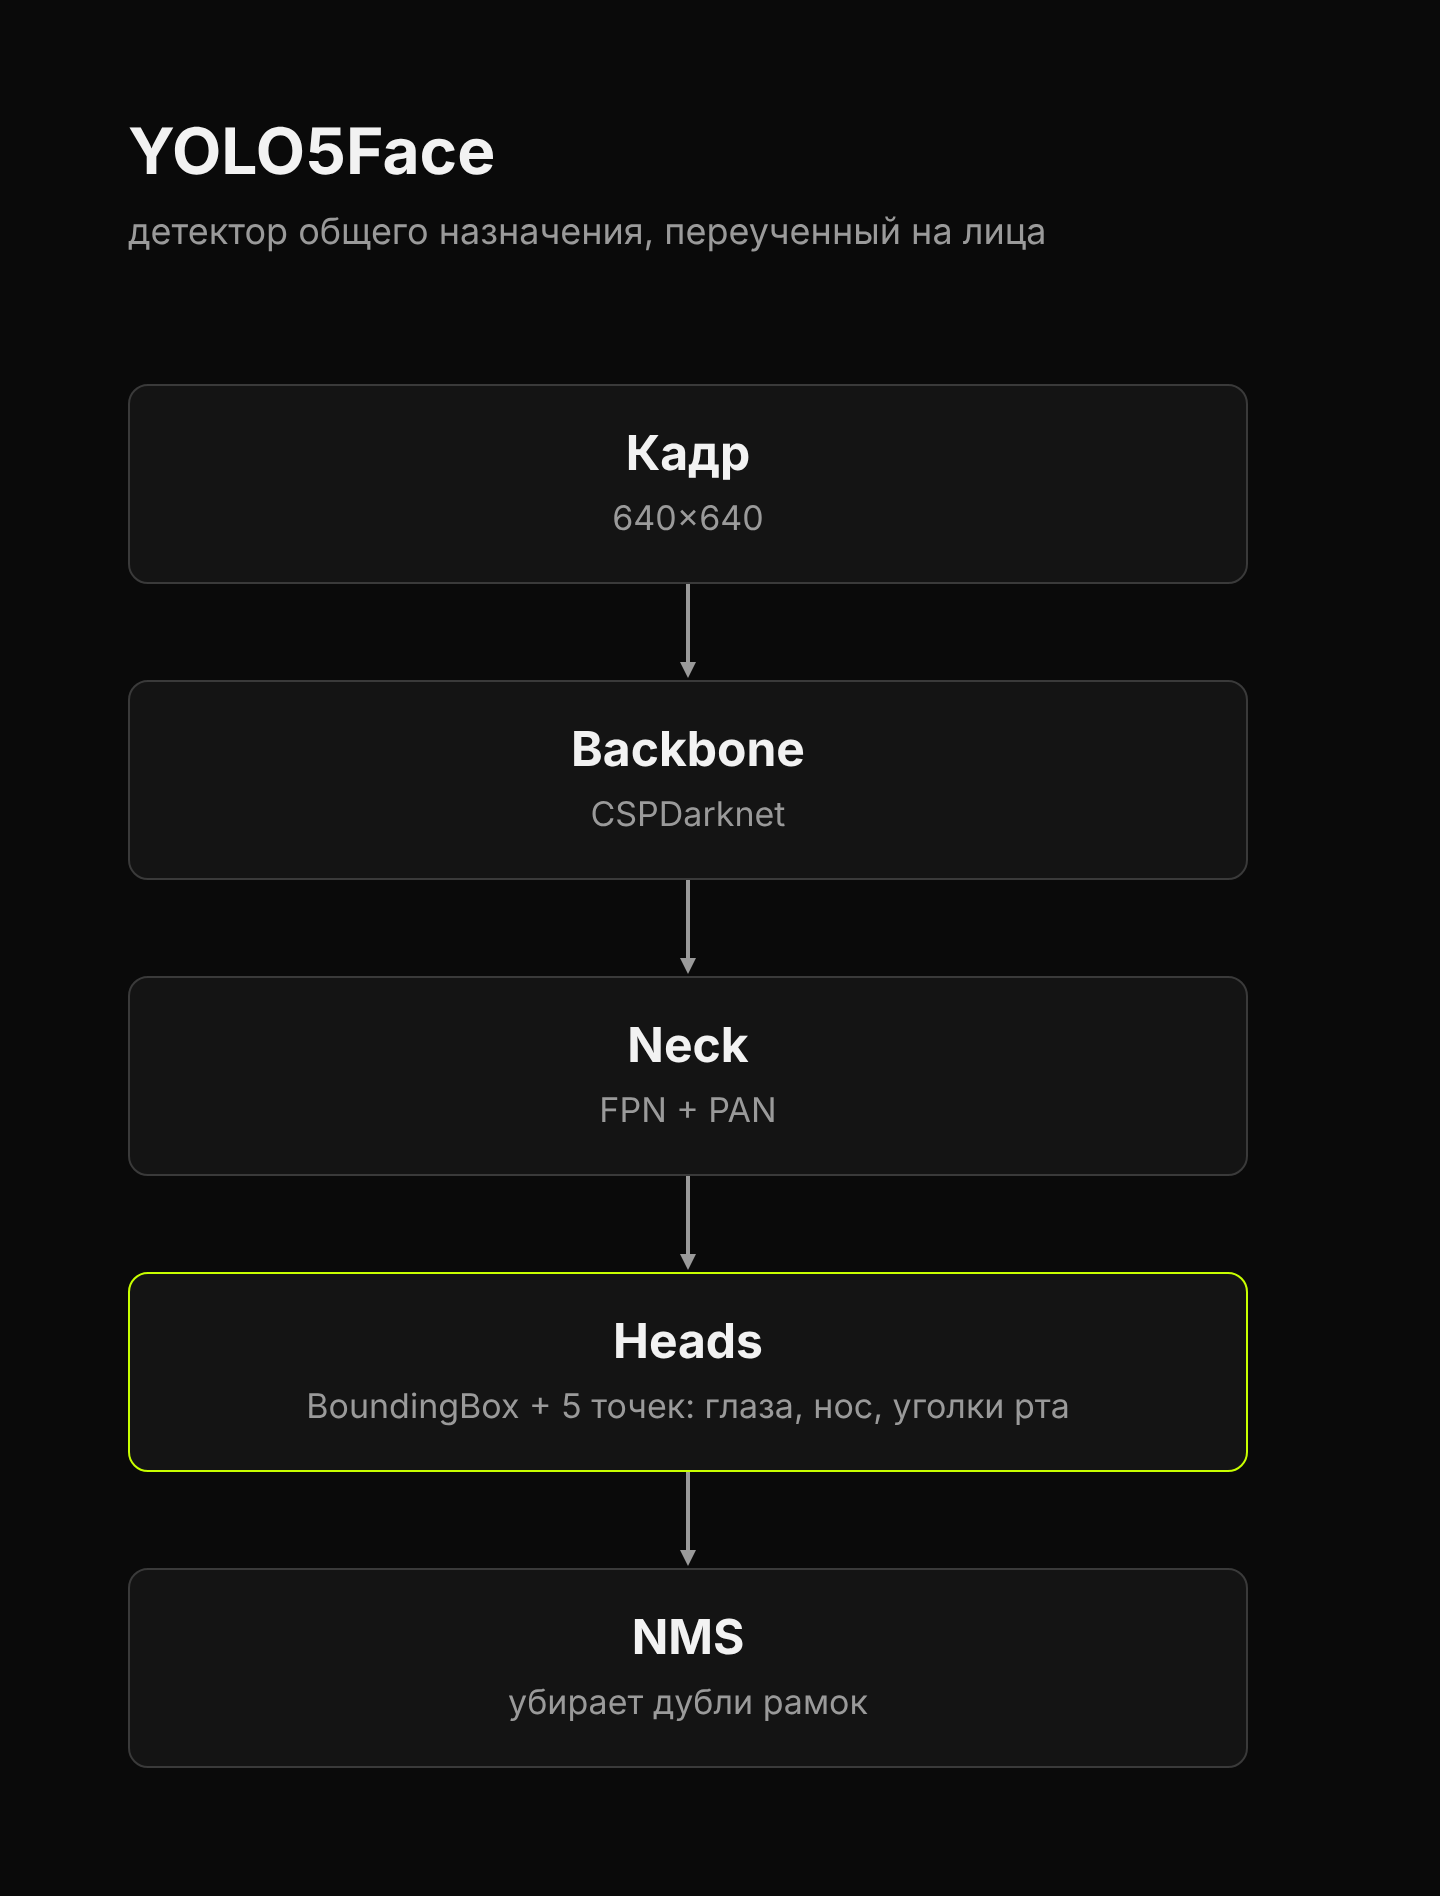
YOLO-face / YOLO5Face (2020–2021) — Qi, Tan, Liu, Wang, Peng, Wu, «YOLO5Face: Why Reinventing a Face Detector». Детектор общего назначения YOLO, переученный на лица (датасет WIDER FACE). Одна сеть за один проход по кадру выдаёт рамки лиц и пять ключевых точек — глаза, нос, уголки рта. Задача, для которой училась: найти все лица на произвольной сцене, включая мелкие, повёрнутые и частично закрытые.
MediaPipe Face Detection (Google, 2019) — BlazeFace, Bazarevsky, Kartynnik, Vakunov, Raveendran, Grundmann, «BlazeFace: Sub-millisecond Neural Face Detection on Mobile GPUs». Сверхлёгкий детектор для телефона: вход 128×128, depthwise-свёртки, около ста тысяч параметров, SSD-схема якорей. Выдаёт рамку и шесть ключевых точек за доли миллисекунды на мобильном GPU. Задача, для которой училась: одно-два крупных лица в кадре фронтальной камеры — селфи, видеозвонки, AR-маски.
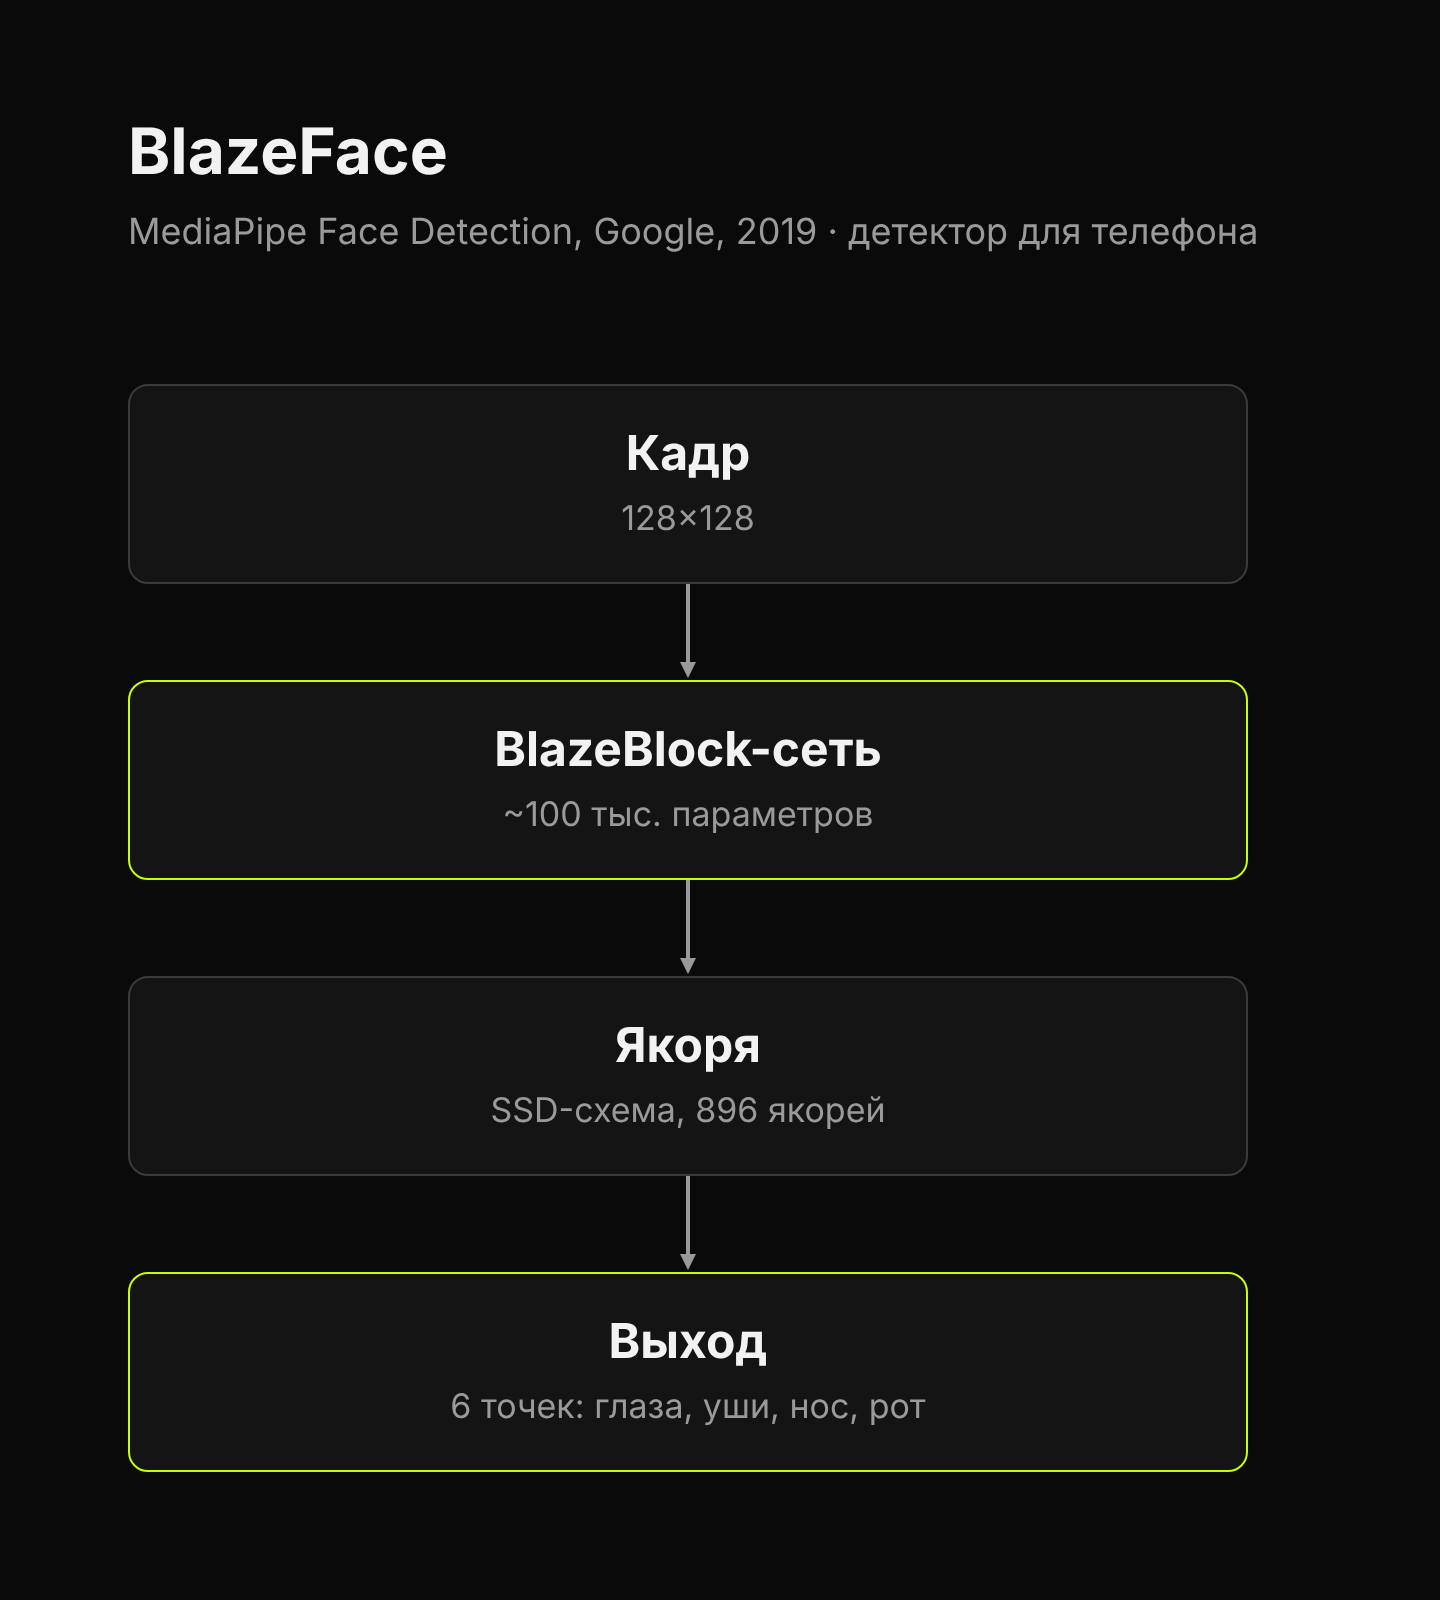
Чем отличаются. YOLO-face точнее на сложных сценах — толпа, мелкие лица, сильные повороты, — но тяжелее и рассчитан на GPU. BlazeFace заточен под один-два крупных лица с фронтальной камеры и работает на телефоне без заметной задержки. В вебе у нас работал MTCNN — каскад из трёх небольших сетей с тем же выходом, что у YOLO-face (рамка и пять точек); в приложении — системный детектор Apple Vision, по классу ближе к BlazeFace.
Определение метрики и задачи машинного обучения
Самая сложная часть начинается именно тут. У заказчика нет оцифрованных данных, поэтому нужно их получить. Есть рабочий аккаунт в Telegram, с которого ведётся диалог с клиентами. Не без приседаний из этого аккаунта спаршивается2 датасет. В датасете две колонки: фотографии клиентов и определённый типаж.
В первом приближении решили оптимизировать accuracy.
Ground Truth — оценки менеджеров, которые верифицировала Мария лично. Такой процесс у заказчика настроен в рамках контроля качества типирования.
ChatGPT показывает значение на уровне 20% относительно датасета — это значит, что 8 из 10 клиентам модель определит неправильный типаж. У менеджера accuracy 80%. Наш пайплайн после дообучения показал 95%.
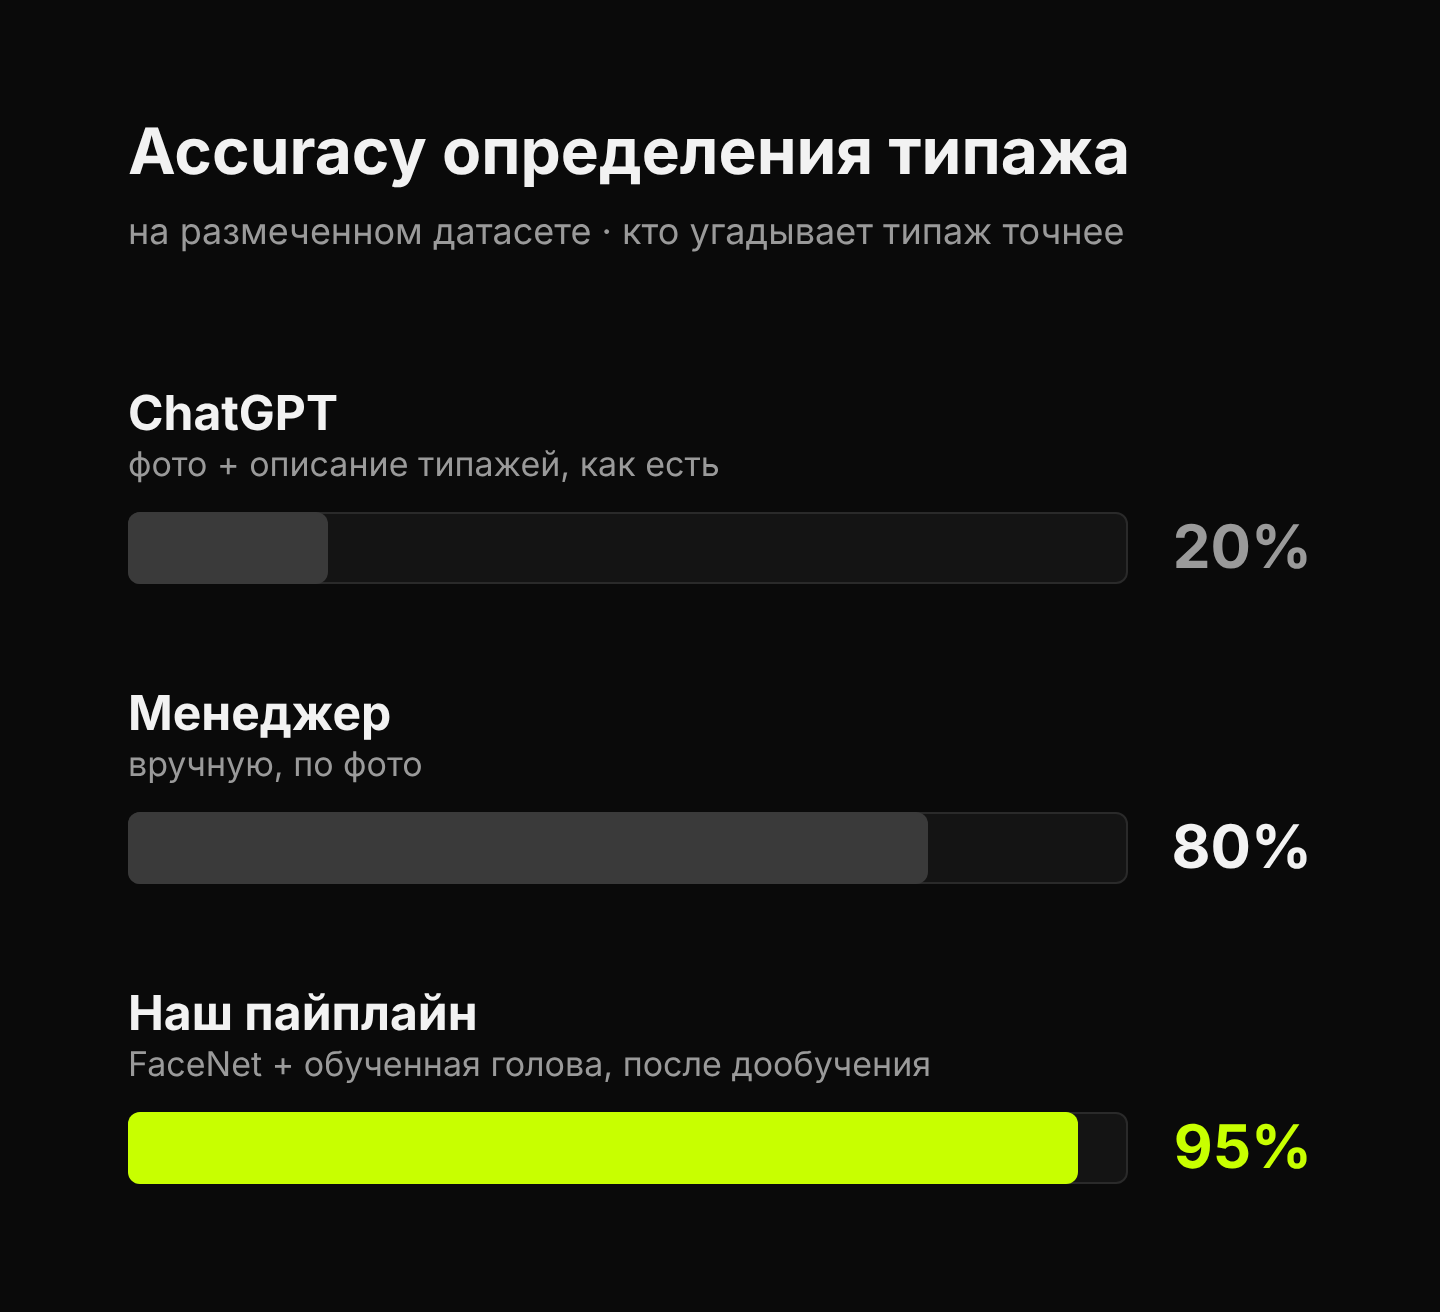
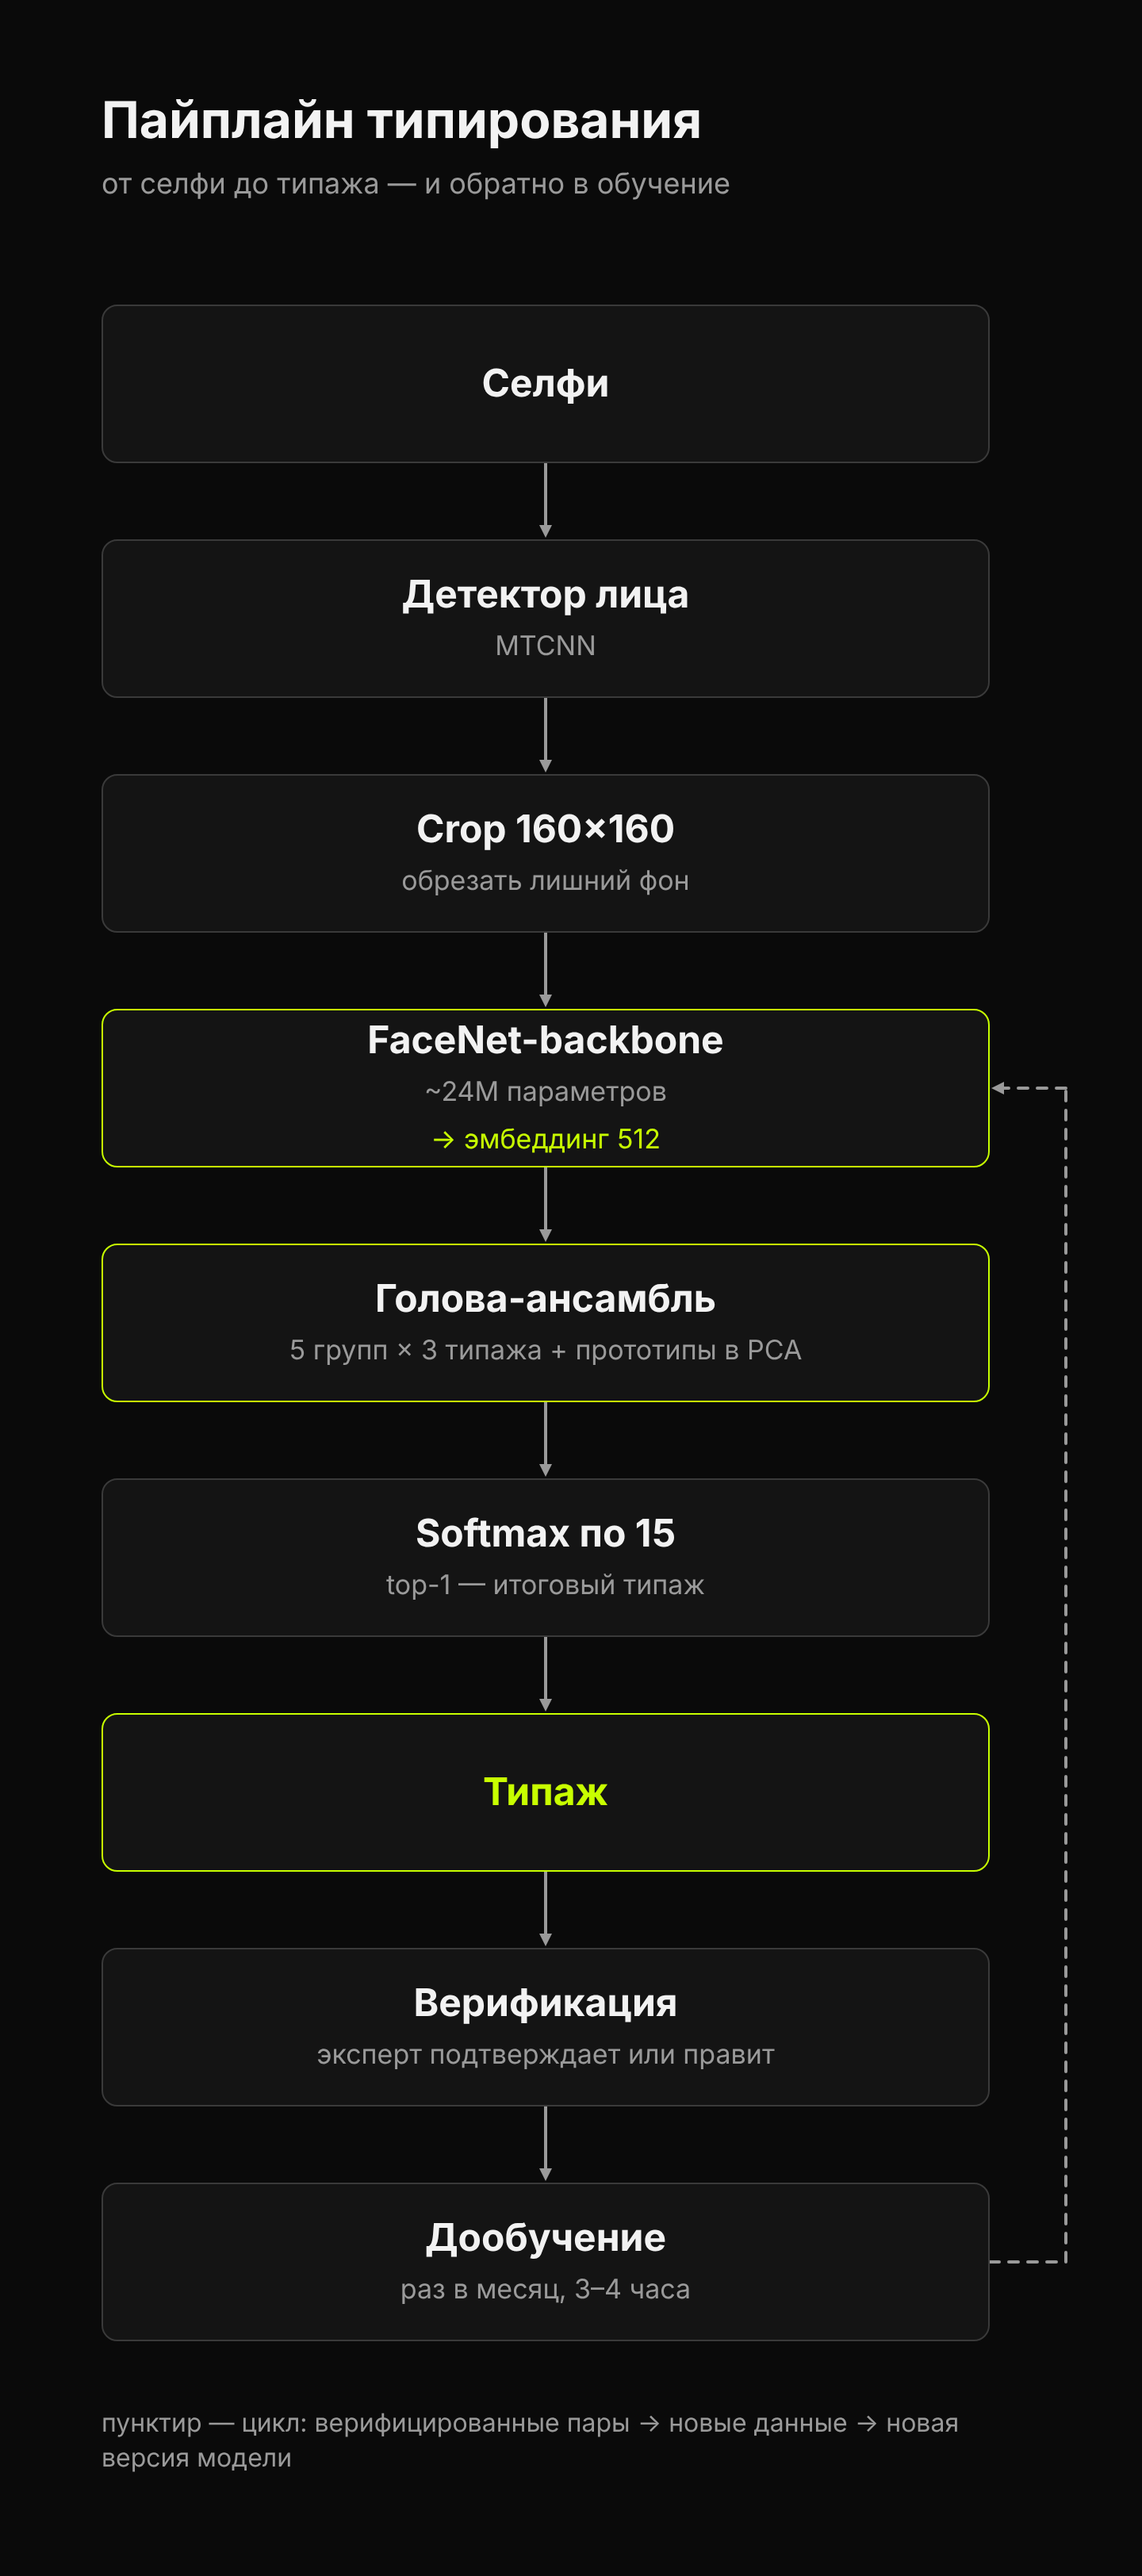
Тест на живых пользователях удался, ai.mne-idet.ru вызвал ажиотаж у аудитории, и по оффлайн-разметке заказчиком результаты оказались отличными.
Ключевой этап оцифрован
Это тот самый момент, когда можно переходить к новым каналам выручки для нашего заказчика. Подробнее изучив рынок и конкурентов, мы нашли три перспективных вектора развития бизнеса заказчика.
- Цифровой гардероб — пользователь фотографирует вещи, приложение каталогизирует их и собирает образы. Конкуренты: Whering (10+ млн пользователей), Acloset (около 8 млн), Indyx, Alta Daily. У всех сборка образов — перетасовка карточек без методики за ней.
- Полная замена стилиста — разбор внешности и советы по фото без человека. Конкуренты: Style DNA (цветотип, тип фигуры и профиль «по мотивам Кибби» по селфи, подписка $8–20 в месяц), Stitch Fix (алгоритм плюс живые стилисты, только США), GPT-стилисты вроде 24ai-style и moleculai. Общая проблема: нет эксперта, который проверяет ответы, поэтому совет у всех одинаковый.
- White-label бизнес-модель Марии на англоговорящем рынке — та же методика и та же модель, другой язык и другой рынок.
Взяли первые две идеи в работу. Благодаря качественным данным из переписок, обучили LLM-обвязку на успешных чатах продажи.
[раздел для описания — черновик, проверь] Из переписок стилистов с клиентками вытащили методологию: по каким критериям эксперт оценивает образ и вещь — линии, цвет, пропорции, посадка, цельность — и какими словами объясняет вердикт. Эти критерии зашили в промпты vision-language-модели: она получает фото, описание типажа и профиль клиентки и ставит словесные оценки по рубрике. Числа модели не доверяем: оценку из 10 считает код по фиксированной формуле с весами, и любое изменение веса — новая версия методики. Промпты меняются на лету, без перевыкладки приложения, поэтому калибровка идёт вместе с заказчиком итерациями по несколько дней.
Цифровой гардероб решили делать на основе типажа, фичей из backbone-ов итераций лица, роста, веса, типа комплекции, типа вещи и самой вещи. Сейчас находимся на этапе сбора данных.
ИИ-стилист работает внутри приложения [ссылка на App Store — после релиза, сейчас TestFlight] и радует клиентов нашего заказчика.
Выводы
- Задача оцифровки данных у клиента — самая важная задача. В бигтехе аналитики и инженеры машинного обучения часто не решают её вообще.
- Частые итерации с заказчиком — залог успеха.
- Side-by-side против живых сотрудников убеждает заказчика лучше любой метрики.
- Платящая и лояльная аудитория — новая нефть.
Стек разработки
MTCNN · FaceNet / InceptionResnet-V1 · PyTorch · Core ML (FP16, on-device) · Vision · Swift / SwiftUI · Go · PostgreSQL · VLM · K3s / Flux GitOps
- ChatGPT-тест — быстрая проверка перед разработкой: даём мультимодальной LLM (ChatGPT, Gemini, Claude) задачу как есть — фото клиентки и описания 15 типажей — и считаем accuracy на размеченном наборе. Если результат близок к случайному, своя модель оправдана; если высокий — хватит промпта.↩
- Экспорт истории чатов из Telegram; фото клиентки сопоставляется с ответом менеджера в том же диалоге, фото без вердикта и дубли отбрасываются.↩